




分支网络出问题查一下午?故障定位慢才是最大的隐性成本
“门店说网络断了,运营商说线路正常,设备商说设备没问题——最后查了一下午,是光猫电源松了。”带多分支网络的 IT 人员,多半经历过这种排障马拉松。故障本身可能只损失半小时业务,但定位过程往往消耗掉一整个下午甚至好几天。这篇讲清楚:为什么分支网络的问题这么难查,以及怎么把定位时间从”小时级”压到”分钟级”。
一、先算算:定位慢也是成本
网络故障的损失由两部分组成:故障持续时间和定位时间的总和。很多企业只盯着前者,实际账单上后者往往更贵:
- 业务损失:门店收银、发货、生产系统停摆,每一分钟都在计损;
- 人力消耗:总部 IT 隔着几十上百公里指挥分支员工”看看灯闪不闪”,效率极低;
- 多方扯皮:运营商说自己的线路没问题,设备商说设备正常,分支说”我们什么都没动”——没有数据,谁都可以把责任推出去。
2~3 人的 IT 团队管着几十个分支时,一次故障耗半天,一个月来几次,一年下来就是实打实的人力成本。
二、为什么分支网络的问题难查
- 看不见:分支没有监控数据,出问题后总部只能靠电话遥控,信息一层层传、一层层失真;
- 环节多:从分支终端、路由器、宽带线路、运营商骨干,到总部出口、业务系统,任何一环都可能出问题;
- 间歇性:最烦人的是”时好时坏”——你远程上去看的时候它正常了,留不下任何证据,下次又犯。
难查的本质不是故障复杂,而是缺少持续记录的链路质量数据。没有数据,排障全凭经验和运气。
三、怎么把排查时间从小时压到分钟
思路很简单:把”故障发生后才开始查”变成”故障发生前数据就在持续记录”。实践中分三步:
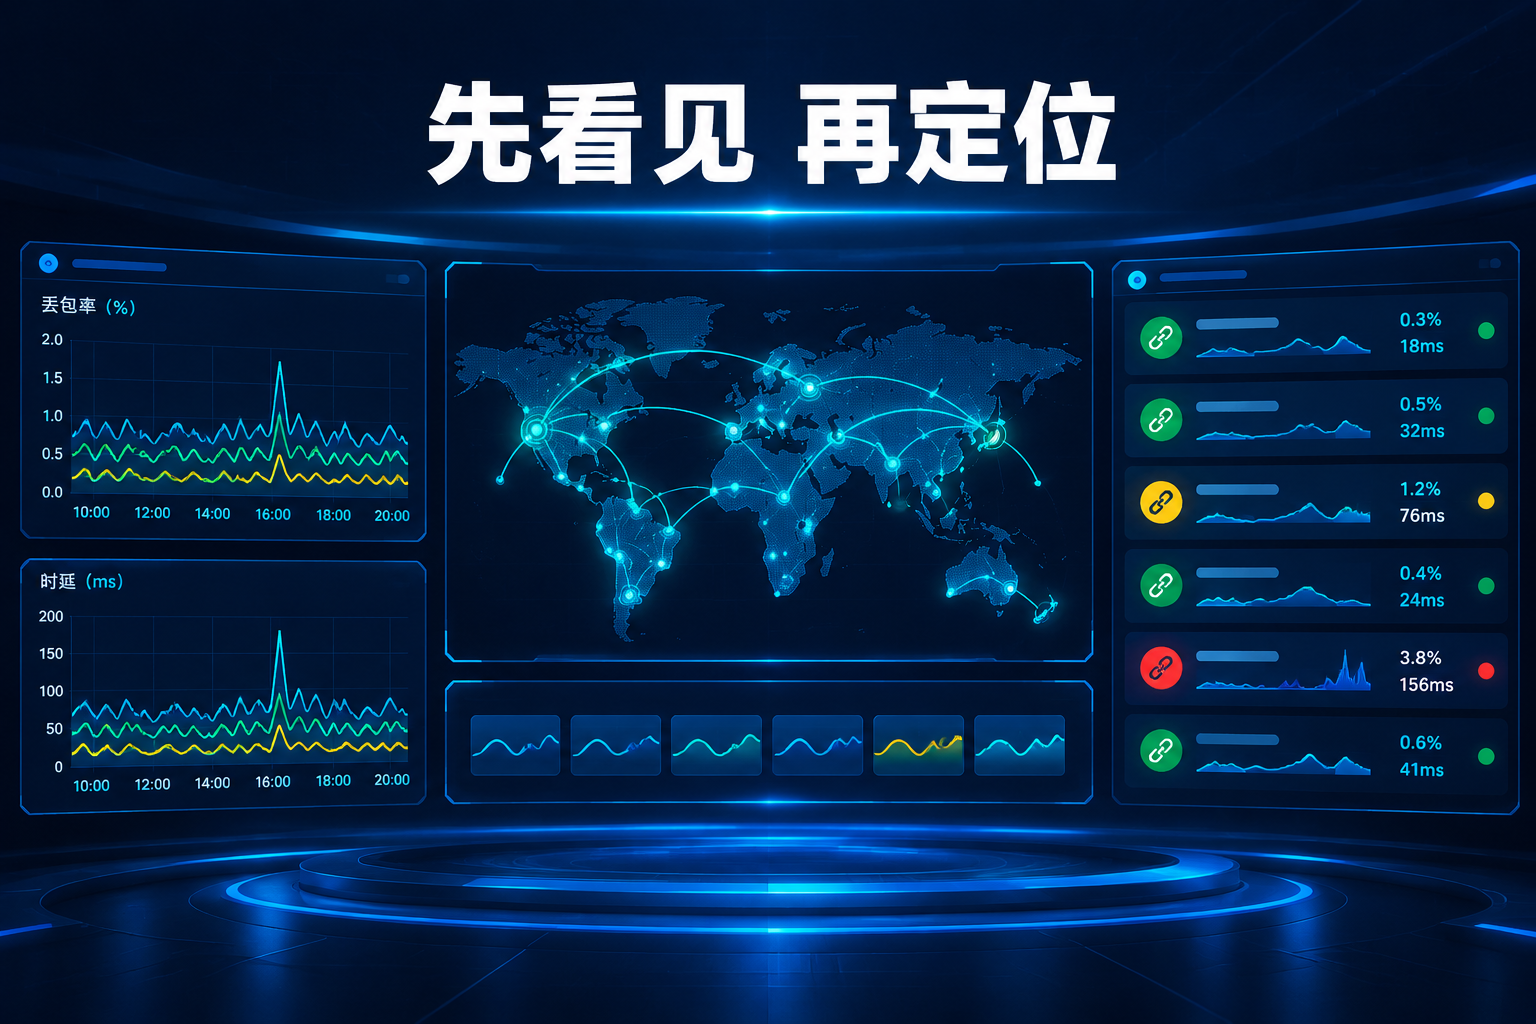
- 采集:每个分支的出口设备持续记录各链路的丢包率、时延、抖动和在线率,形成历史曲线;
- 分段:把”分支到总部”这一条大链路拆成分支本地、接入线路、运营商骨干、总部侧四段,每段都有独立数据;
- 告警:指标越过阈值自动告警,往往业务还没感知,IT 已经在处理了。
有了这三步,大多数常见问题可以直接对号入座:
| 现象 | 数据会显示什么 | 责任通常在哪 |
|---|---|---|
| 单个分支时断时续 | 该分支某条线路丢包率曲线规律性飙升 | 接入线路或分支本地设备 |
| 多个分支同时变慢 | 各分支到总部时延同步升高 | 总部出口或运营商骨干 |
| 只有某个业务卡 | 其他业务指标正常,特定应用流量异常 | 业务系统或对该应用的策略配置 |
| 分支员工”感觉网断了” | 链路在线率曲线显示从未中断 | 终端或误报,无需出工 |
定位从”排除法猜”变成”看曲线指”,这正是排障提速的关键。
四、SD-WAN 平台天然带这套能力
这也是 SD-WAN 常被低估的价值:大家谈论它的多链路和选路,但对企业 IT 同样重要的是它的全网可视化。微恩云 SD-WAN 平台上,每个分支的每条链路都在持续上报质量数据:
- 一屏看全网:几十个分支的链路状态、丢包、时延集中展示,异常一眼可见;
- 历史可回溯:间歇性故障不再”查无实据”,任何时间段的曲线都能调出来;
- 数据说话:与运营商沟通时直接甩出丢包曲线,责任判定不再扯皮;
- 远程运维:多数问题云端看数据就能定责,不必派人或遥控分支员工折腾。
五、写在最后
如果你管着多个分支的网络,不妨回想一下最近三次排障花了多久、定位依据是什么。如果答案是”打电话问、一个个排除”,那值得了解一下微恩云 SD-WAN 的全网可视化能力——故障定位快不快,取决于数据在不在。欢迎联系我们做一次演示,看看你自己的网络在监控大屏上长什么样。